Guide IA, information, communication numérique & cybersécurité
45 à 55 min
Groupe de 3 ou 4
Carnet Canva
Lors de l’étape précédente, vous avez commencé à suivre la transformation du texte de votre demande.
Votre représentation s’est enrichie :
Mais notre schéma contient toujours un élément volontairement non expliqué :
?
Nous voyons une réponse apparaître à l’écran.
Parfois longue.
Parfois structurée.
Parfois très précise.
Parfois différente alors que nous avons formulé exactement la même demande.
Comment cette réponse est-elle produite ?
Dans cette étape, nous allons essayer de déterminer comment une suite de texte peut être construite par le modèle, et ce que ce mécanisme nous permet — ou non — de conclure sur la réponse obtenue.
Comme précédemment :
nous allons d’abord observer avant de nommer le mécanisme.
Lisez cette amorce :
Sans utiliser d’IA, complétez immédiatement cette phrase.
Maintenant, sans effacer votre première réponse, imaginez trois autres suites possibles.
| SUITE ENVISAGEE | SUITE ENVISAGÉEVOUS SEMBLE-T-ELLE TRÈS PLAUSIBLE, POSSIBLE OU PEU PLAUSIBLE ? | |
|---|---|---|
| 1 1 | ||
| 2 | ||
| 3 |
Comparez vos propositions au sein du groupe.
Pour le moment, ne cherchez pas à établir si vos propositions sont vraies.
Nous nous intéressons uniquement à la manière dont vous avez imaginé une suite possible.
Pour le moment, ne cherchez pas à établir si vos propositions sont vraies.
Nous nous intéressons uniquement à la manière dont vous avez imaginé une suite possible.
Utilisez maintenant un même modèle, dans les mêmes conditions autant que possible.
Donnez-lui uniquement la consigne suivante :
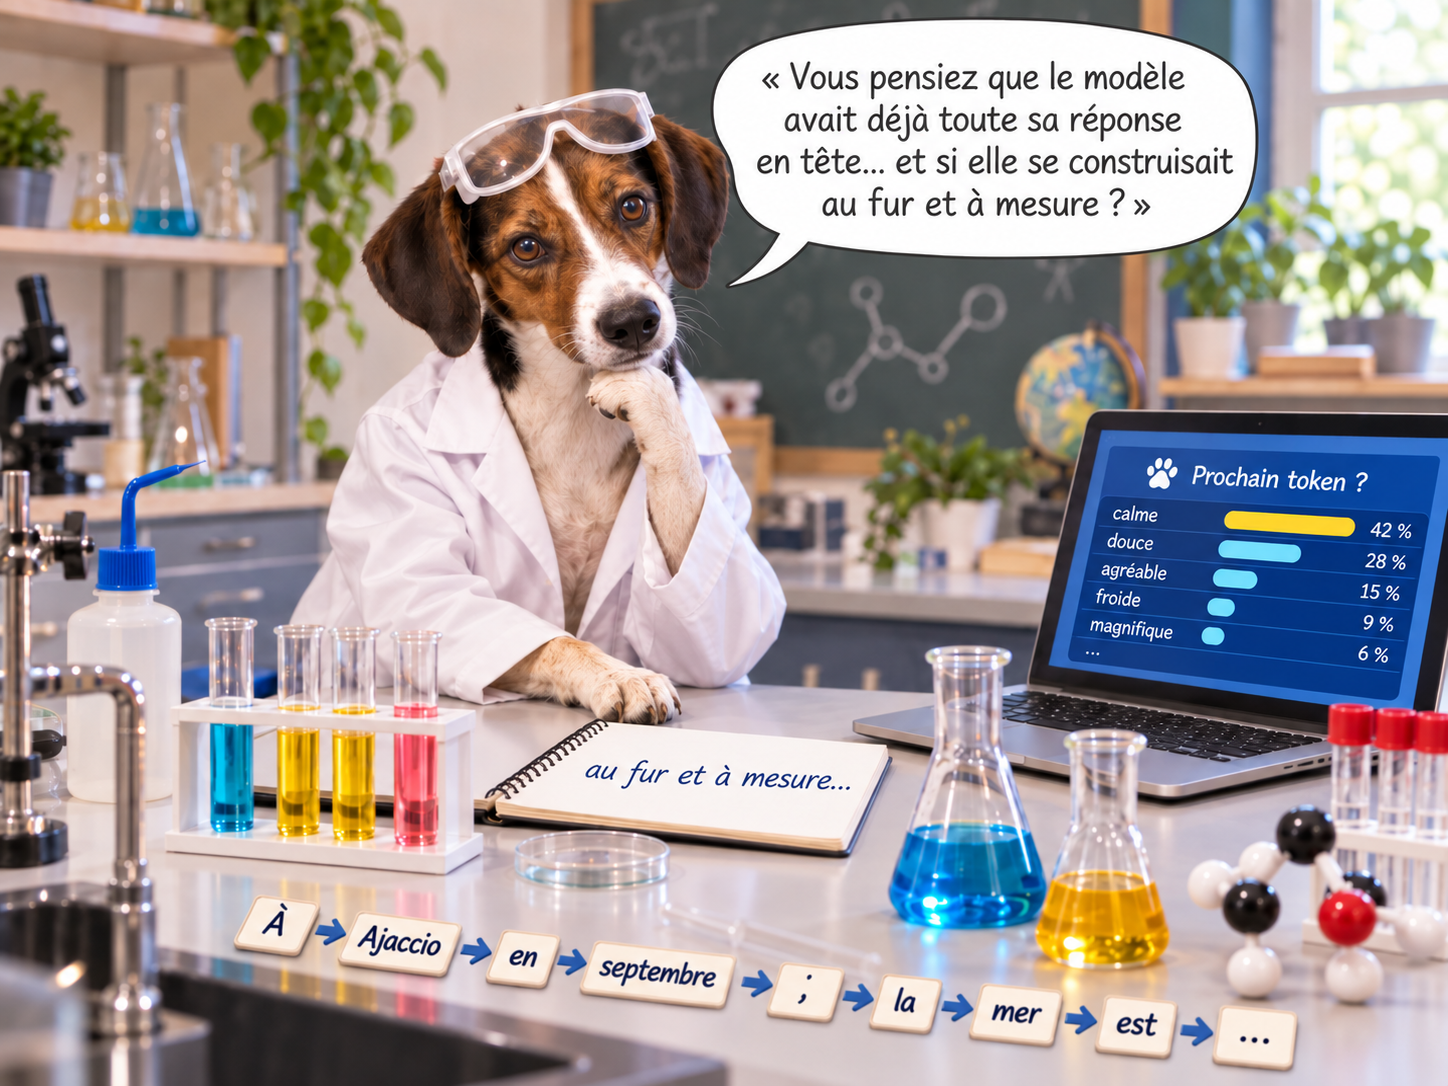
« À Ajaccio en septembre, la mer est... »
Conservez la première suite obtenue.
Puis recommencez plusieurs fois, lorsque le système utilisé permet de réaliser les essais dans des conditions comparables.
| ESSAI | SUITE OBTENUE | IDENTIQUE A L ‘ESSAI PRÉCÉDENT ? |
|---|---|---|
| 1 | ||
| 2 | ||
| 3 | ||
| 4 | ||
| 5 |
Si vous utilisez un service conversationnel, vous ne maîtrisez pas nécessairement tous les paramètres susceptibles d’intervenir.
Une différence entre deux réponses ne permet donc pas, à elle seule, d’en identifier la cause.
Notez seulement ce que vous observez.
À partir de ce que vous avez observé, proposez deux mécanismes différents qui pourraient expliquer comment le système produit la suite d’un texte. Pour chacun, indiquez aussi une observation qui le rendrait moins plausible. Ne cherchez pas encore à choisir la « bonne » explication : il faut d’abord pouvoir les départager.
Pour cette expérience, utilisez un outil indiqué par l’enseignant permettant, lorsque cela est disponible, d’observer plusieurs tokens susceptibles d’être générés à une position donnée ainsi que leurs scores ou probabilités associées.
Vous pouvez utiliser un environnement officiel ou documenté exposant ces informations.
Si le système utilisé habituellement ne permet pas de les afficher, utilisez le jeu de résultats fourni par l’enseignant.
Nous ne cherchons pas ici à apprendre une API.
Nous cherchons à observer certaines informations associées au calcul qui précède la sélection d’un token.
Entrez une même amorce.
Par exemple :
Relevez plusieurs tokens candidats et les valeurs affichées par l’outil.
| TOKEN POSSIBLE | SCORE / PROBABILITÉ AFFICHÉE | A-T-IL ÉTÉ SÉLECTIONNÉ ? |
|---|---|---|
Les outils de génération peuvent exposer plusieurs tokens considérés comme probables à une étape donnée, avec des log-probabilités associées ; la distribution est conditionnée par ce qui précède dans la séquence.
Ne généralisez pas au-delà de vos données.
Votre conclusion reste limitée au modèle, à l’entrée et à la configuration effectivement observés.
Nous pouvons maintenant commencer à nommer ce que nous avons observé.
Pour une séquence donnée, un modèle de langage autorégressif calcule des scores pour les tokens susceptibles de poursuivre la séquence. Ces scores peuvent être convertis en une distribution utilisée lors de la génération.
Le token retenu est ajouté à la séquence, produit des scores associés aux tokens susceptibles de poursuivre la séquence
Les systèmes de génération de texte fondés sur ce principe construisent ainsi progressivement leur sortie.
Nous pouvons représenter ce processus de manière simplifiée :
token A      score
token B      score
token C      score
...
Le processus recommence.
Le token nouvellement produit fait désormais partie de ce qui précède la prochaine génération.
C’est cette répétition qui permet de construire progressivement une séquence de texte.
Concevez deux amorces qui ne diffèrent que par un seul élément susceptible, selon vous, de modifier les continuations proposées par le modèle.
Choisissez votre amorce de départ et notez-la dans votre carnet avant l’essai.
Avant tout essai, définissez l’élément modifié, ce que vous cherchez à maintenir constant, votre prédiction et un résultat qui fragiliserait votre interprétation.
Modifiez un seul élément de la version A et notez cette seconde amorce dans votre carnet.
Réalisez ensuite les essais avec le même outil et le même modèle lorsque cela est possible. Relevez les premiers tokens candidats, leurs valeurs et le token finalement produit.
| VERSION A | VERSION B | |
|---|---|---|
| Token candidat 1 | ||
| Token candidat 2 | ||
| Token candidat 3 | ||
| Token finalement produit |
La génération d’un token dépend de la séquence prise en compte à ce moment du traitement.
Lorsque le contexte change, les scores attribués aux suites possibles peuvent également changer.
Et chaque token généré modifie à son tour le contexte utilisé pour la suite.
Nous pouvons donc enrichir notre représentation :
TOKENS POSSIBLES
Cette représentation reste volontairement simplifiée.
Elle permet de représenter le principe de génération que nous sommes en train d’étudier ; elle ne décrit pas l’intégralité des traitements internes du modèle.
Vous savez maintenant qu’un modèle peut associer plusieurs valeurs à plusieurs continuations possibles. Avant toute nouvelle expérience, écrivez vos critères de décision.
Utilisez ensuite, lorsque l’outil le permet, un environnement dans lequel les paramètres de génération sont visibles.
Conservez la même entrée et comparez plusieurs conditions.
Ne modifiez qu’un seul paramètre à la fois et notez ce qui doit rester constant.
Vous pourrez notamment observer la température lorsque le modèle ou l’outil choisi l’expose.
Produire une suite ne signifie pas nécessairement sélectionner systématiquement, à chaque étape, le token ayant le score le plus élevé.
Selon la méthode de décodage et la configuration utilisées, un token peut être échantillonné parmi plusieurs candidats.
Certains systèmes exposent des paramètres permettant de modifier cette sélection.
Par exemple, lorsqu’une température est disponible, l’effet exact dépend cependant du système et de la manière dont ce paramètre est implémenté.
D’autres mécanismes peuvent également intervenir selon le système utilisé.
TEMPÉRATURE ≠ « CRÉATIVITÉ »
Ce mot est parfois utilisé pour vulgariser son effet.
Mais le paramètre agit sur la distribution utilisée lors de la sélection des tokens.
Une réponse qui varie davantage n’est pas, pour cette raison, « plus créative » au sens humain du terme.
Et surtout :
tous les services ne donnent pas nécessairement accès aux mêmes paramètres.
Votre objectif n’est pas de « jouer avec le réglage », mais de déterminer ce que vos résultats permettent réellement d’attribuer à un paramètre de génération. Avant les essais, consignez dans votre carnet ce que vous maintenez constant, ce que vous appellerez une variation et ce qui fragiliserait votre interprétation.
Lorsque l’outil l’autorise, comparez trois valeurs suffisamment différentes de température. Pour chaque configuration, écrivez votre prédiction avant d’observer les résultats, puis réalisez deux essais comparables.
| CONFIGURATION | PRÉDICTION AVANT ESSAIS | ESSAI 1 | ESSAI 2 | ÉCARTS / VARIATIONS OBSERVÉS |
|---|---|---|---|---|
| Température basse | ||||
| Température intermédiaire | ||||
| Température plus élevée |
Reprenez notre lieu fictif :
Vous savez déjà qu’il a été inventé pour nos expériences.
Cette fois, ne fournissez aucune information supplémentaire à son sujet.
Demandez par exemple :
Complétez uniquement cette phrase : “Le musée de Santa Luna à Ajaccio se trouve...”
Observez ce que produit le système.
Le système vient de produire une affirmation précise et linguistiquement plausible à propos de Santa Luna.
Dans le cas de Santa Luna, nous connaissons nous-mêmes la condition expérimentale : le lieu a été inventé pour nos expériences.
Utilisez cette certitude seulement pour évaluer la relation entre plausibilité linguistique et réalité extérieure.
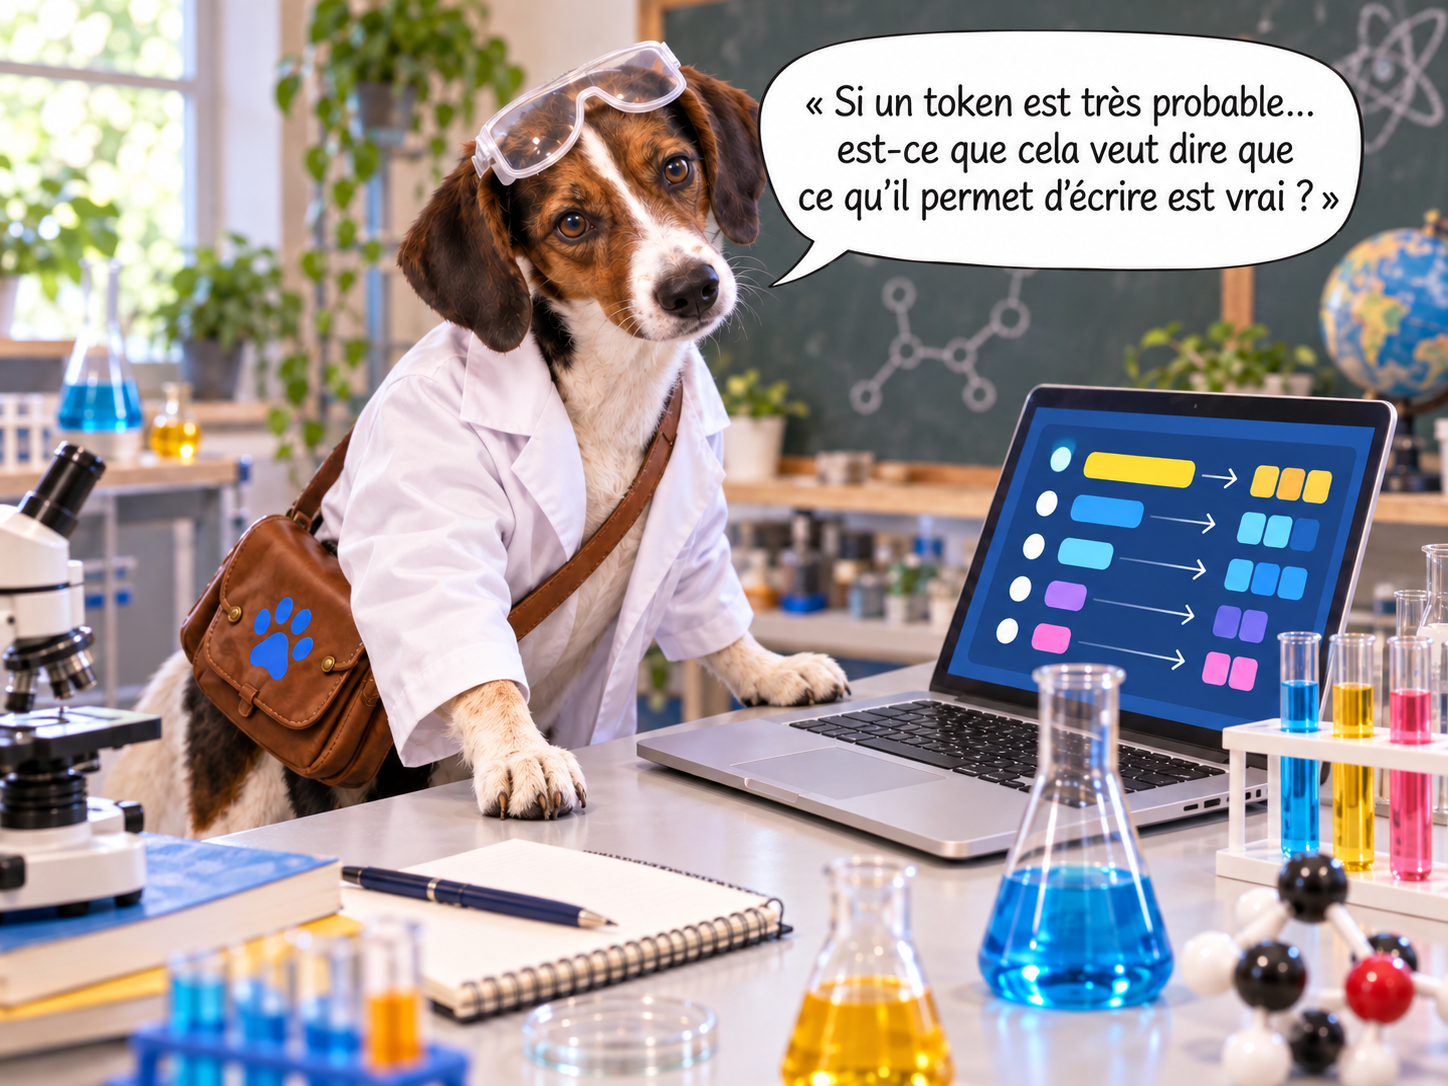
Une probabilité ou un score associé à un token concerne sa génération dans le contexte considéré.
Ce n’est pas, à lui seul :
une probabilité que l’information produite soit vraie.
Cette distinction est fondamentale.
Un modèle peut produire une séquence linguistiquement très plausible sans que cela constitue une vérification de la réalité décrite.
La génération probabiliste et la vérification factuelle sont deux problèmes différents.
À partir de ce schéma de fin d’étape 5, reconstruisez dans votre carnet ce que vous placeriez aujourd’hui à la place du ?. N’ouvrez la page suivante qu’après avoir terminé votre proposition.
NUMÉRIQUES
TOKENS POSSIBLES
Comparez maintenant votre représentation avec ce schéma de synthèse. Toute différence doit être expliquée, pas simplement corrigée.
Dans votre carnet, attribuez à chaque élément ou flèche de votre propre schéma un statut : ÉTABLI PAR NOS OBSERVATIONS / DÉDUIT – MODÈLE EXPLICATIF / ? – ENCORE INCONNU.
Le ? ne disparaît pas complètement : nous ne savons toujours pas suffisamment :
- pourquoi certains tokens deviennent plus probables que d’autres ;
- d’où proviennent les régularités que le modèle utilise ;
- ce que signifie exactement dire qu’un modèle a « appris » quelque chose ;
- ni ce qu’il peut réellement « savoir ».
À partir des expériences réalisées, nous pouvons maintenant établir que, pour les modèles de langage autorégressifs étudiés ici, la génération d’une réponse peut être représentée comme un processus progressif : à partir du contexte disponible, des scores sont associés aux tokens susceptibles de poursuivre la séquence ; un token est ensuite retenu selon la stratégie de génération utilisée, puis le processus recommence à partir du contexte enrichi.
Les outils de génération peuvent exposer des scores associés aux tokens à chaque étape.
La même entrée ne conduit pas nécessairement à une sortie strictement identique lorsque la stratégie de génération comporte de l’échantillonnage ou lorsque d’autres paramètres du système diffèrent.
Les paramètres de génération peuvent modifier la sélection des tokens lorsqu’ils sont disponibles.
Et surtout :
Conservez votre hypothèse initiale, vos explications concurrentes, vos protocoles écrits avant les essais, vos prédictions, les générations obtenues, l’observation des tokens candidats lorsqu’elle était disponible, l’expérience de modification du contexte, les essais avec différents paramètres de génération lorsqu’ils étaient accessibles, les résultats concernant Santa Luna, votre schéma enrichi et les éléments que cette étape vous a conduit à modifier dans votre représentation.
Puis complétez :
Une réponse n’a pas nécessairement été construite comme un texte complet puis simplement affichée.
Dans les modèles autorégressifs étudiés ici, la génération se construit progressivement à partir de tokens successifs.
À chaque étape, le contexte disponible intervient dans le calcul des suites possibles.
Plusieurs continuations peuvent être possibles.
La stratégie de génération peut intervenir dans la sélection du token produit.
Une suite très probable pour le modèle n’est pas, pour cette raison, une information vérifiée.
PROBABLE ≠ VRAI
📓 Carnet
Vos réponses enregistrées dans le carnet sont conservées dans ce navigateur.