CYBER ONE — ÉTAPE 5
1 / 30
ETAPE 5 – QUE FAIT LE MODÈLE AVEC VOTRE TEXTE ?

Guide IA, information, communication numérique & cybersécurité

REPÈRES
⏱ 40 à 50 min
👥 Groupe de 2 étudiants + 1 troisième étudiant facultatif
📓 Carnet Canva
NOMS DU GROUPE


OBJECTIF
🎯

Lors de l’étape précédente, nous avons commencé à distinguer plusieurs éléments susceptibles d’intervenir entre votre demande et la réponse obtenue.

L’un d’entre eux reste encore largement une boîte noire :

LE MODÈLE

Nous écrivons des phrases.

Nous utilisons des mots.

Nous ajoutons de la ponctuation, des nombres, parfois des emojis, des noms propres ou des termes dans plusieurs langues.

Mais est-ce réellement sous cette forme que le modèle traite notre demande ?

Dans cette étape, nous allons suivre ce que devient le texte de votre demande lorsqu’il est transmis au modèle.

Nous chercherons à déterminer :

  • comment le texte de votre demande est transformé avant d’être traité par le modèle ;
  • si le modèle le découpe nécessairement comme nous le faisons ;
  • ce que ces transformations nous permettent — ou non — de comprendre de son fonctionnement.

Mais, comme précédemment, nous ne commencerons pas par les définitions.

SITUATION
👁

Observez cette phrase :

Nous partons trois jours à Ajaccio en septembre.

Pour vous, elle est composée de mots.

Vous pouvez les compter.

Vous pouvez identifier une phrase, des espaces, une ponctuation et un nom propre.

Imaginez maintenant que cette phrase soit envoyée à un modèle de langage.

Que reçoit réellement le modèle ?
La phrase entière ?
Les mots ?
Les lettres ?
Des morceaux de mots ?
Des nombres ?
Autre chose ?

Avant de poursuivre, représentez ce que vous pensez que le modèle reçoit réellement.

Ne cherchez pas la bonne réponse : indiquez aussi ce dont vous n’êtes pas certains.

HYPOTHÈSE
💡
Sans rechercher de définition, représentez ce que vous pensez se produire entre le texte saisi et le modèle. Vous pouvez utiliser des mots, des flèches ou un schéma.
Dans votre représentation, distinguez ce que vous supposez de ce que vous pensez déjà pouvoir établir.
MÉTHODE
🧭

Sans utiliser d’outil, travaillez sur cette phrase :

Nous partons trois jours à Ajaccio en septembre.
Proposez au moins deux découpages différents qui vous paraissent plausibles pour une machine. Pour chacun, justifiez les frontières choisies.
Qu’est-ce qui permettrait de départager vos propositions ?

Il n’existe pas encore de réponse attendue à ce stade.

COMPAREZ
⚖
Comparez vos propositions. Identifiez un désaccord qui repose sur deux conceptions différentes de la manière dont le texte pourrait être traité.
Pour chacune de ces conceptions, formulez ce que vous vous attendez à observer avec le tokenizer.
TESTEZ VOTRE REPRÉSENTATION
🛠

Utilisez maintenant un tokenizer officiel ou documenté correspondant à une famille de modèles étudiée.

Pour cette première observation, tous les groupes utilisent le même tokenizer de référence afin de pouvoir comparer leurs résultats.

Entrez exactement la même phrase :

Nous partons trois jours à Ajaccio en septembre.

Ne modifiez pas vos propositions avant d’observer le résultat.

Avant puis après le test, relevez :
Tokenizer utilisé :
Modèle ou famille de modèles auquel il est associé :
Quelle source vous permet d’établir cette association ?
Avant le test, quelle représentation votre groupe juge-t-il la plus plausible ? Quel résultat l’affaiblirait ?
Quel découpage observez-vous réellement ?
Quelle proposition est fragilisée ? Laquelle reste compatible avec l’observation ?
Que pouvez-vous conclure à partir de ce test ? Que ne pouvez-vous pas conclure ?
PREMIER CONCEPT – LE TOKEN
🔎

Vous venez d’observer le fonctionnement d’un tokenizer.

Dans les modèles de langage, le texte est généralement transformé en tokens, c’est-à-dire en unités déterminées par le système de tokenisation utilisé.

Un token peut correspondre, selon les cas et le tokenizer :

  • à un mot entier ;
  • à une partie de mot ;
  • à un signe de ponctuation ;
  • à un nombre ou une partie de celui-ci ;
  • à un espace associé à une autre unité ;
  • ou à d’autres séquences de caractères.
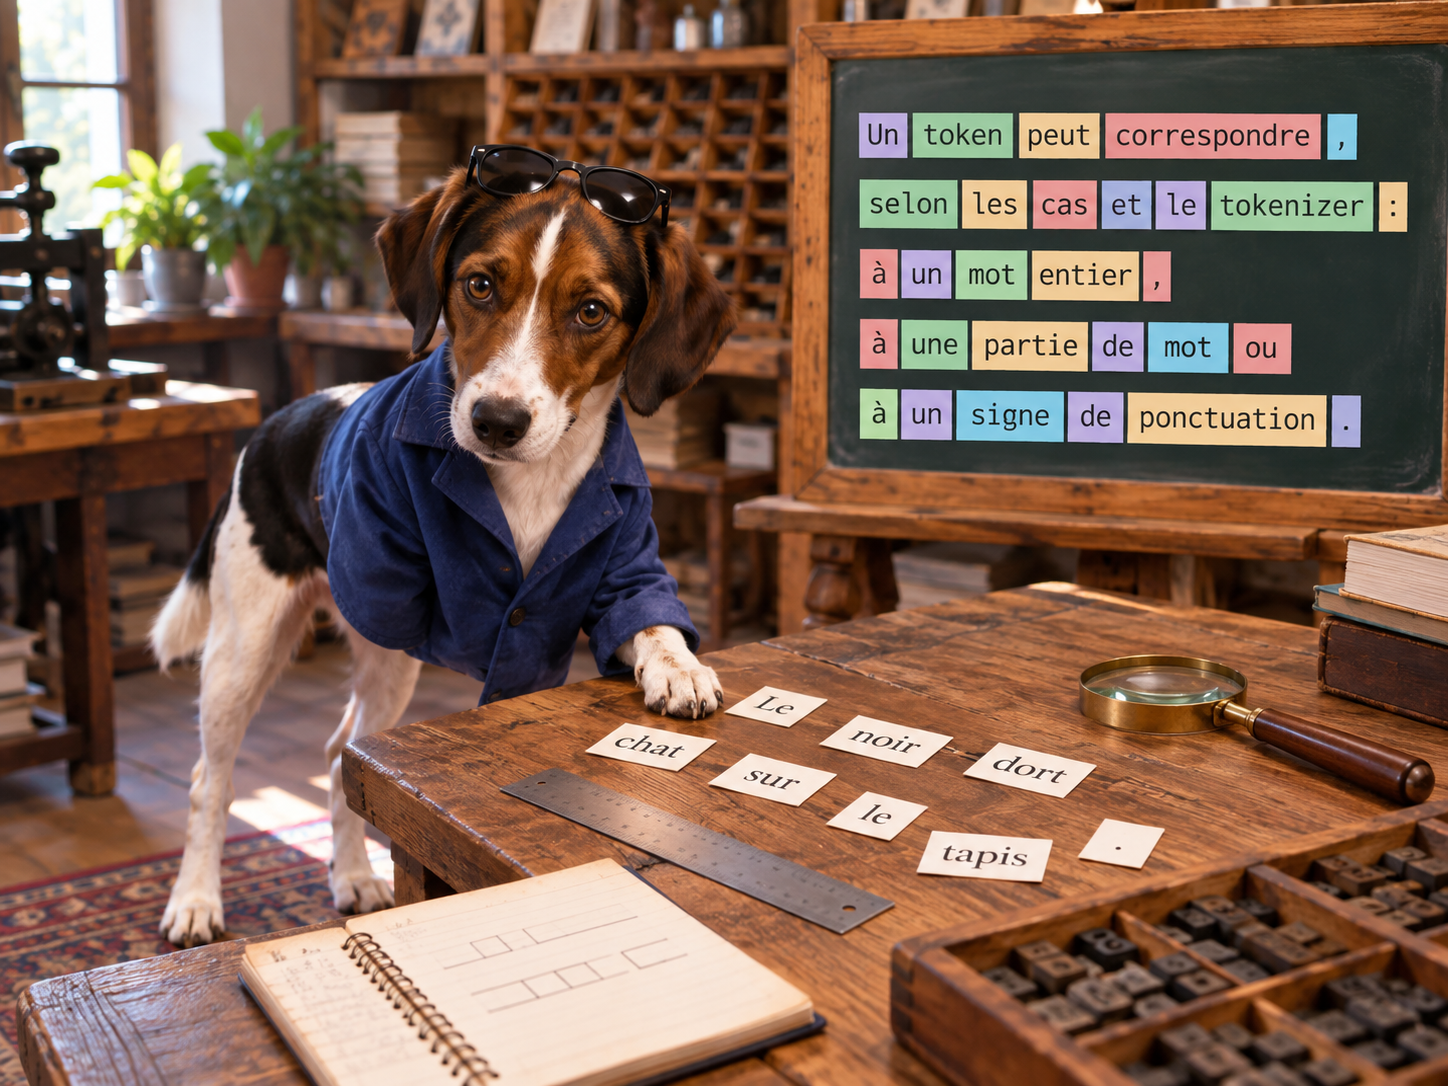
Dumè — premier concept : le token
ATTENTION
⚠
TOKEN ≠ MOT

Et surtout :

le découpage n’est pas nécessairement identique d’un tokenizer à l’autre.

Nous n’allons donc pas apprendre :

« un token = X caractères »

comme une règle universelle.

Ce serait précisément le type de simplification que notre démarche cherche à éviter.

4 – FAITES VARIER LE TEXTE
🧪

Vous allez maintenant concevoir votre propre série d’essais afin de mettre à l’épreuve votre représentation de la tokenisation.

Chaque essai doit avoir une raison d’exister.

Lorsque c’est possible, ne modifiez qu’un élément à la fois.

Avant chaque essai, notez ce que vous pensez observer.

Votre série doit contenir au moins un résultat susceptible de contredire votre hypothèse.
Quelle logique allez-vous suivre pour construire votre série d’essais ?
TABLEAU
📊

Consignez uniquement les essais que votre groupe juge réellement informatifs.

TEXTE TESTÉCE QUE NOUS MODIFIONSNOTRE PRÉDICTIONRÉSULTAT OBSERVÉCE QUE LE RÉSULTAT CHANGE DANS NOTRE MODÈLE
COMPAREZ
⚖
À partir de vos résultats, quelles régularités pensez-vous avoir identifiées ?
Lesquelles résistent à plusieurs essais ?
Quelle affirmation initiale avez-vous dû abandonner ou nuancer ?
Pouvez-vous construire une règle qui permette de prévoir exactement la tokenisation ? Si oui, quelle observation pourrait la réfuter ?
Si vous ne pouvez pas formuler une telle règle, qu’est-ce qui vous empêche de conclure ?
N’extrapolez pas trop vite.

Vous observez un tokenizer particulier sur quelques exemples.

Vos résultats ne suffisent pas encore à formuler une règle universelle.

DUMÈ / QUESTION
🐾
Dumè / question
5 – ET SI NOUS CHANGEONS DE TOKENIZER ?
🧪

Jusqu’à présent, vous avez observé un seul tokenizer.

Mais pouvons-nous supposer que tous les modèles découpent nécessairement le même texte de la même manière ?

Reprenez exactement la même phrase :

Nous partons trois jours à Ajaccio en septembre.
Choisissez deux autres tokenizers dont la comparaison vous paraît réellement informative. Justifiez votre choix.
Avant de tester, prévoyez-vous le même découpage ou un découpage différent ? Pourquoi ?

Identifiez des tokenizers associés à des modèles ou à des familles de modèles différents lorsque cette information et un outil permettant de les observer sont disponibles.

Utilisez en priorité un outil officiel ou un tokenizer publié ou documenté par l’organisation à l’origine du modèle.

Vous pouvez utiliser un comparateur multi-tokenizers pour explorer rapidement plusieurs découpages.

ATTENTION
⚠

Un comparateur tiers constitue un outil d’exploration.

Le résultat qu’il affiche ne suffit pas, à lui seul, à établir que le modèle ou le service que vous utilisez actuellement emploie exactement ce tokenizer.

Lorsque cela est possible, vérifiez cette association dans une source officielle.

TABLEAU
📊

Complétez le tableau en distinguant ce que vous observez de ce que vos sources permettent réellement d’établir.

MÊME TEXTEMODÈLE / FAMILLETOKENIZER IDENTIFIÉSOURCE DE L’ASSOCIATION + NIVEAU DE CERTITUDENOMBRE DE TOKENSDÉCOUPAGE VISIBLE
Nous partons trois jours à Ajaccio en septembre.
Texte strictement identique
COMPAREZ
⚖
Les trois tokenizers produisent-ils exactement le même nombre de tokens ? Découpent-ils le texte aux mêmes endroits ? Quelles différences observez-vous ?
Pouvez-vous établir avec certitude quel tokenizer est associé à chaque modèle étudié ?
Pour quelles associations disposez-vous d’une source officielle ?
Pour lesquelles reste-t-il une incertitude ?
Pour chaque association, classez votre conclusion : établie / fortement documentée / plausible / non établie. Justifiez.
Une absence d’information suffisamment établie est elle-même une information à conserver.

Ne remplacez pas ce que vous ne savez pas par une supposition.

CE QUE CETTE COMPARAISON NOUS APPREND
🔎
À partir de ce que vous venez d’observer, proposez votre propre représentation des relations entre service, tokenizer et modèle. Placez un « ? » partout où l’association n’est pas suffisamment établie.

Confrontez maintenant votre représentation aux éléments suivants :

Un même texte peut être découpé différemment selon le tokenizer utilisé.

Plusieurs modèles peuvent utiliser des tokenizers différents.

Certains modèles peuvent également partager un même tokenizer ou une même famille de tokenisation.

Nous devons donc éviter de transformer l’observation réalisée avec un tokenizer particulier en règle applicable à tous les modèles.

De même, lorsque vous utilisez un service tel qu’un assistant conversationnel, ne confondez pas automatiquement :
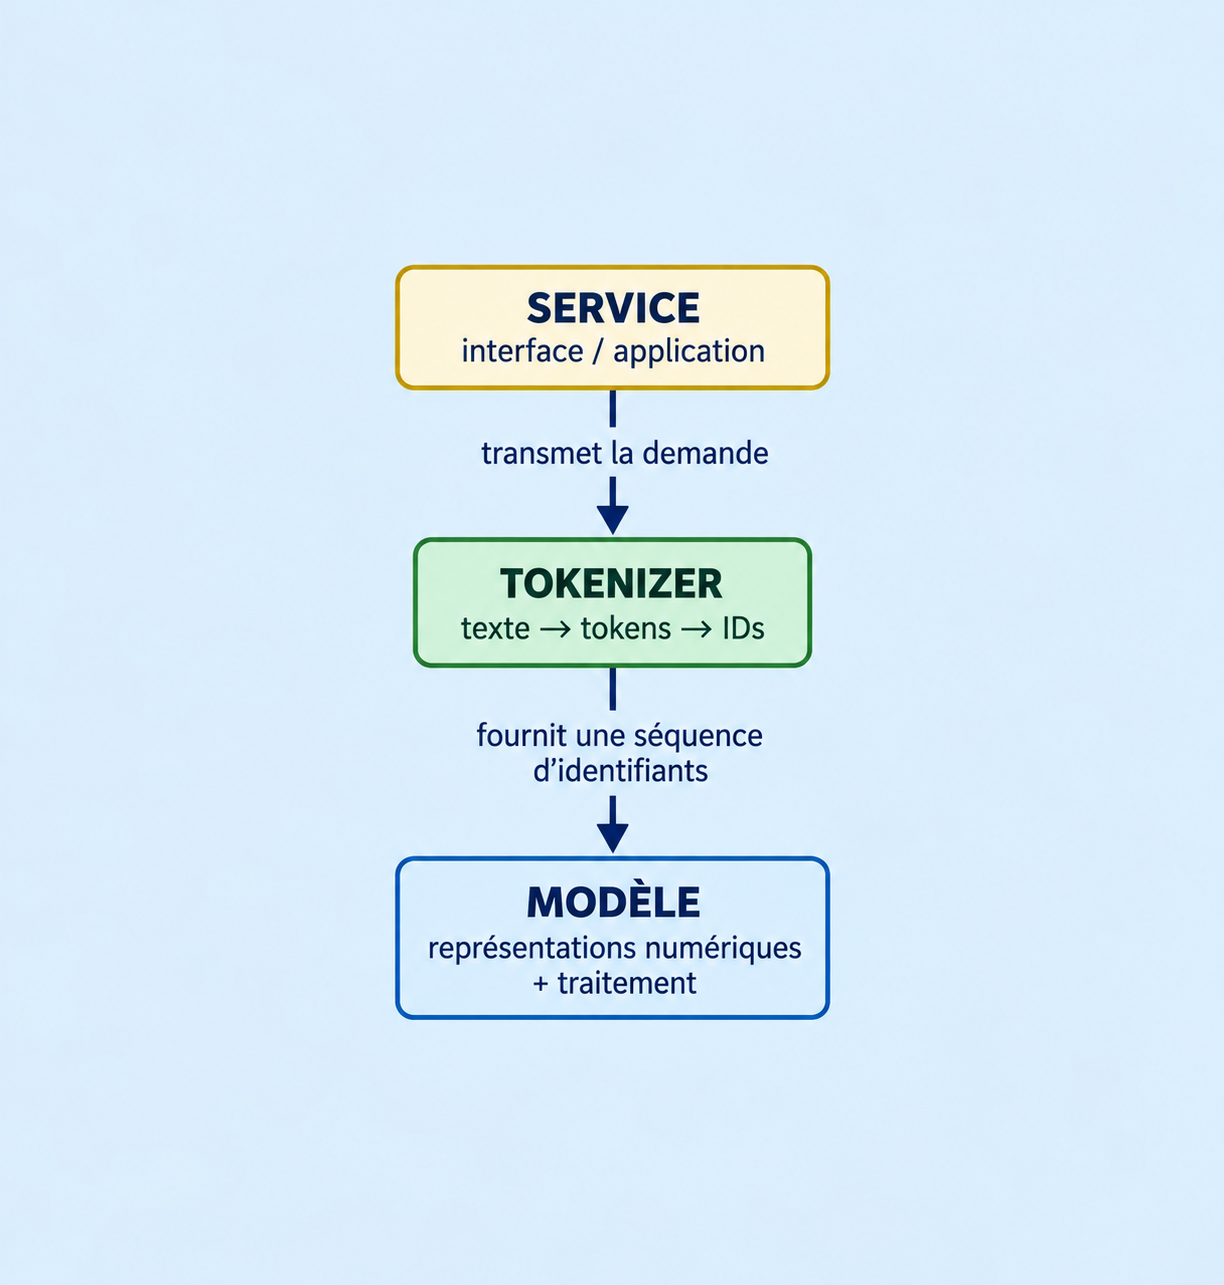
Schéma SERVICE → TOKENIZER → MODÈLE

L’étape précédente nous a appris à distinguer les composantes d’un système.

Cette distinction reste nécessaire ici.

6 – MAIS QUE DEVIENNENT CES TOKENS ?
🧪

Le tokenizer vous montre des morceaux de texte.

Mais le modèle ne manipule pas directement les mots tels que vous les voyez à l’écran.

À partir du tokenizer utilisé, les tokens sont associés à des identifiants numériques.

Lorsque l’outil utilisé le permet, affichez maintenant l’identifiant associé à chaque token.

TOKEN → IDENTIFIANT

Vous pouvez représenter cette étape ainsi :

TEXTE
  ↓
TOKENISATION
  ↓
TOKEN 1 | TOKEN 2 | TOKEN 3 | TOKEN 4...
  ↓
ID 1    | ID 2    | ID 3    | ID 4…
Observez plusieurs tokens et leurs identifiants. Quelles interprétations différentes pourriez-vous donner à ces nombres ?
Le numéro associé à un token représente-t-il nécessairement son « sens » ?

Ne cherchez pas encore à conclure : conservez plusieurs explications compatibles avec ce que vous observez.

VOTRE HYPOTHÈSE
💡
Formulez au moins deux explications différentes compatibles avec ce que vous observez concernant le rôle de l’identifiant numérique.
Qu’est-ce qui vous conduit à conserver chacune de ces explications ?
Quelle observation ou quelle information permettrait de départager ces explications ?
DU TOKEN À UNE REPRÉSENTATION NUMÉRIQUE
🔎

L’identifiant permet de désigner une unité dans le vocabulaire utilisé par le tokenizer.

Mais sa valeur numérique ne constitue pas, à elle seule, une mesure de sa signification.

Le modèle associe ensuite ces unités à des représentations numériques apprises qui seront utilisées dans les traitements suivants. À ce stade, il n’est pas nécessaire d’en connaître précisément le fonctionnement mathématique.

Revenez à vos hypothèses. Laquelle pouvez-vous maintenant écarter ou modifier ? Quel élément vous autorise à le faire ?
Quelle explication reste encore compatible avec ce que vous savez ? Que reste-t-il inconnu ?

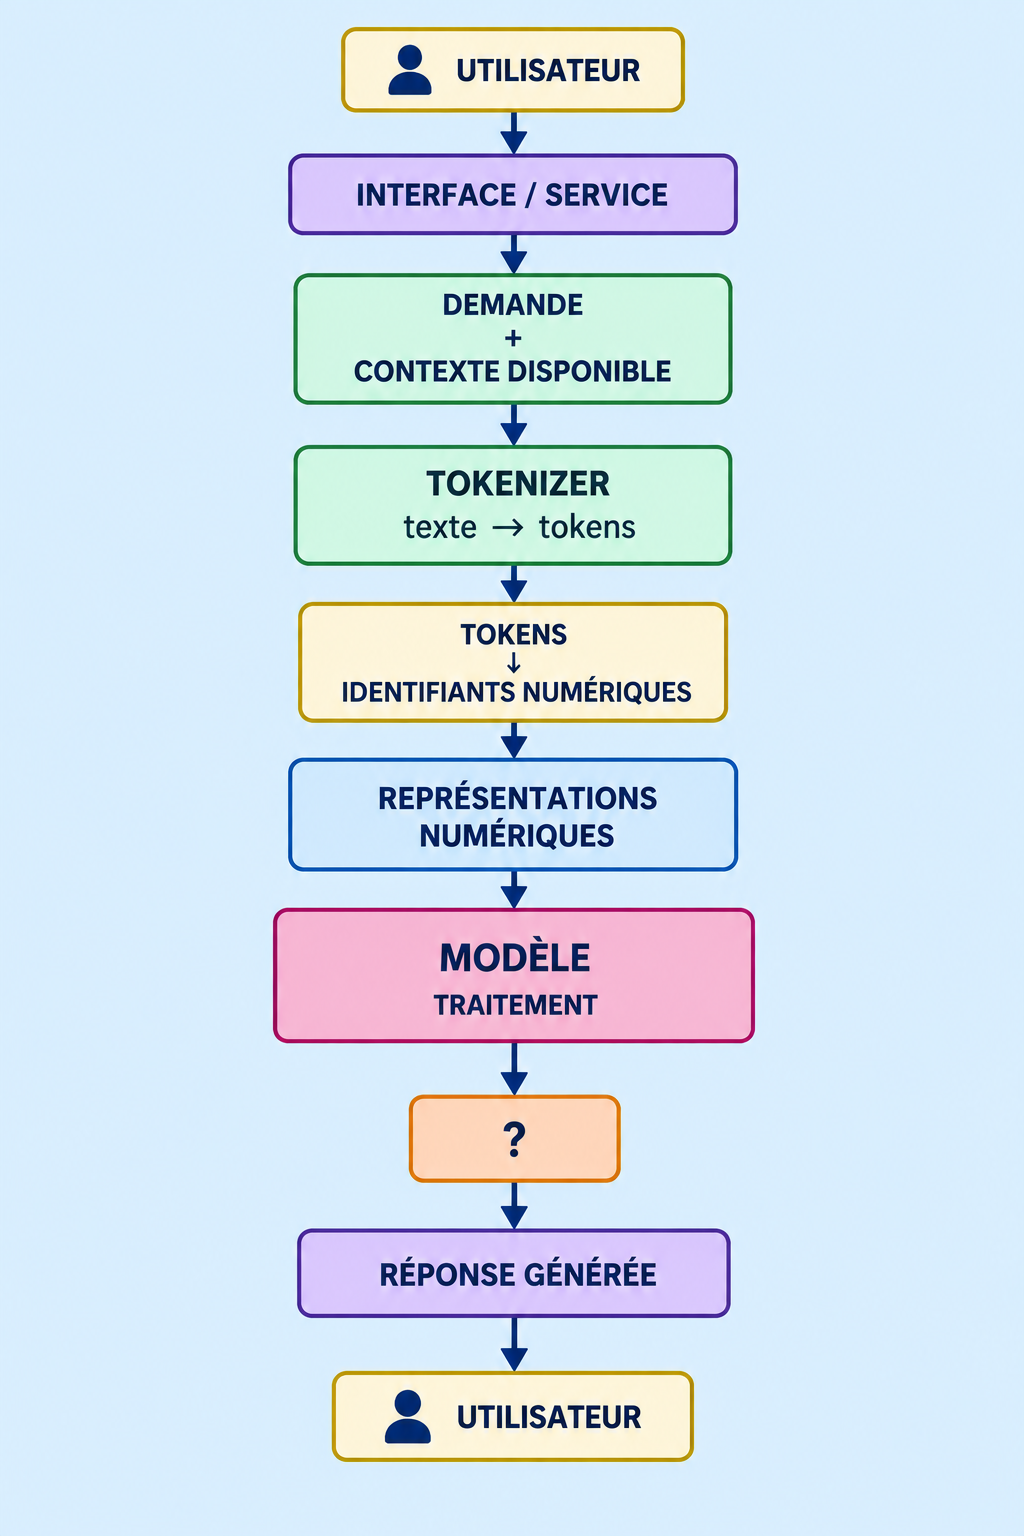
Nous pouvons maintenant représenter le chemin parcouru par notre texte :
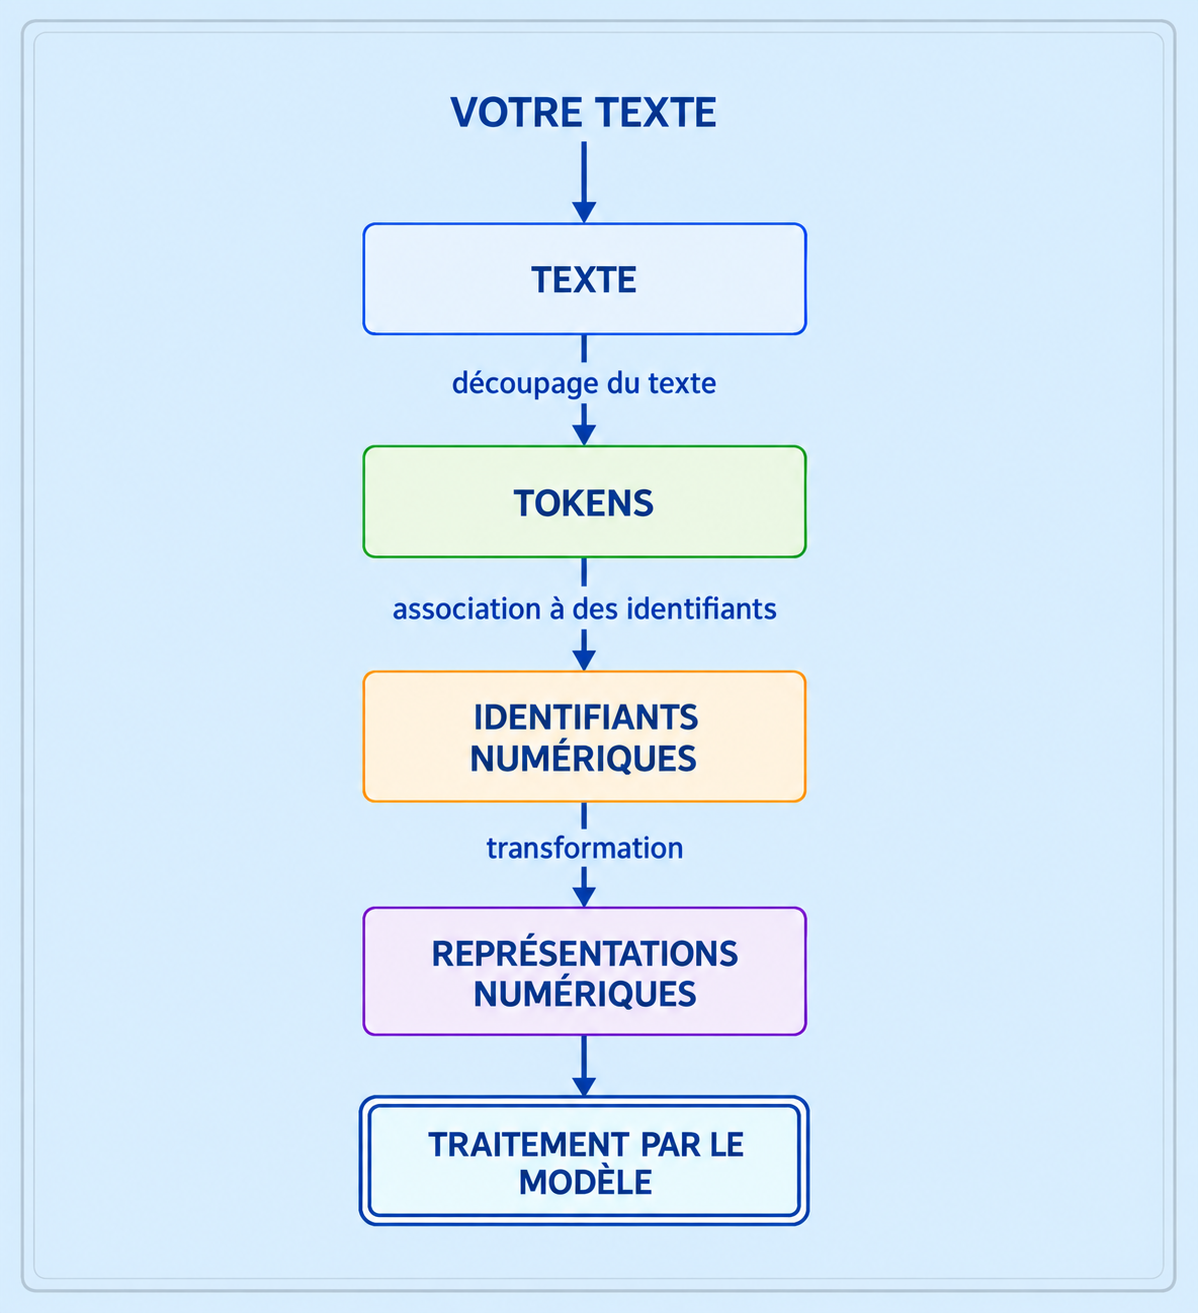
DU TEXTE AU TRAITEMENT PAR LE MODÈLE
Schéma du texte au traitement par le modèle

À ce stade, nous savons mieux comment le texte devient traitable par le modèle. Nous ne savons pas encore comment celui-ci produit la réponse.

7 – ET SI LE TEXTE EST TROP LONG ?
🧪

Nous avons observé comment notre texte peut être découpé et transformé avant son traitement par le modèle.

Supposons maintenant que deux services semblent accepter des quantités de texte différentes.

Quelles explications concurrentes pourraient être compatibles avec cette observation ?

La limite dépend-elle du modèle, du service, de l’interface ou d’un autre élément du système ?

Que faudrait-il connaître pour pouvoir départager ces explications ?

Avant de rechercher la réponse, formulez votre représentation.

VOTRE HYPOTHÈSE
💡
Dans votre modèle actuel du système, où situez-vous cette limite ?
Qu’est-ce qui vous permet de la placer ici ?
Quelle information pourrait vous obliger à déplacer cette limite dans votre représentation ?
VÉRIFIEZ
🔎

Recherchez maintenant, dans la documentation officielle du modèle ou du service que vous utilisez, les informations disponibles concernant la quantité de contexte pouvant être prise en compte.

Notez précisément :

Système / service :
Modèle observé :
Limite annoncée :
Unité utilisée :
Source officielle :
Date de consultation :
Si plusieurs valeurs apparaissent dans la documentation, laquelle s’applique réellement à votre cas et comment le savez-vous ?
Comparez vos résultats avec ceux des autres groupes.

Avez-vous trouvé les mêmes valeurs ? Parlez-vous exactement du même modèle, du même service et de la même version ?

Les informations consultées sont-elles datées ?

CONCEPT – LA FENETRE DE CONTEXTE
🔎

Les modèles disposent d’une capacité limitée concernant la quantité d’informations pouvant être prise en compte dans un contexte donné.

Cette limite est généralement exprimée en tokens.

On parle couramment de fenêtre de contexte.

8 – REVENEZ À VOTRE PREMIÈRE REPRÉSENTATION
⚖

Reprenez maintenant le modèle construit à l’étape précédente.

Vous aviez commencé à représenter :
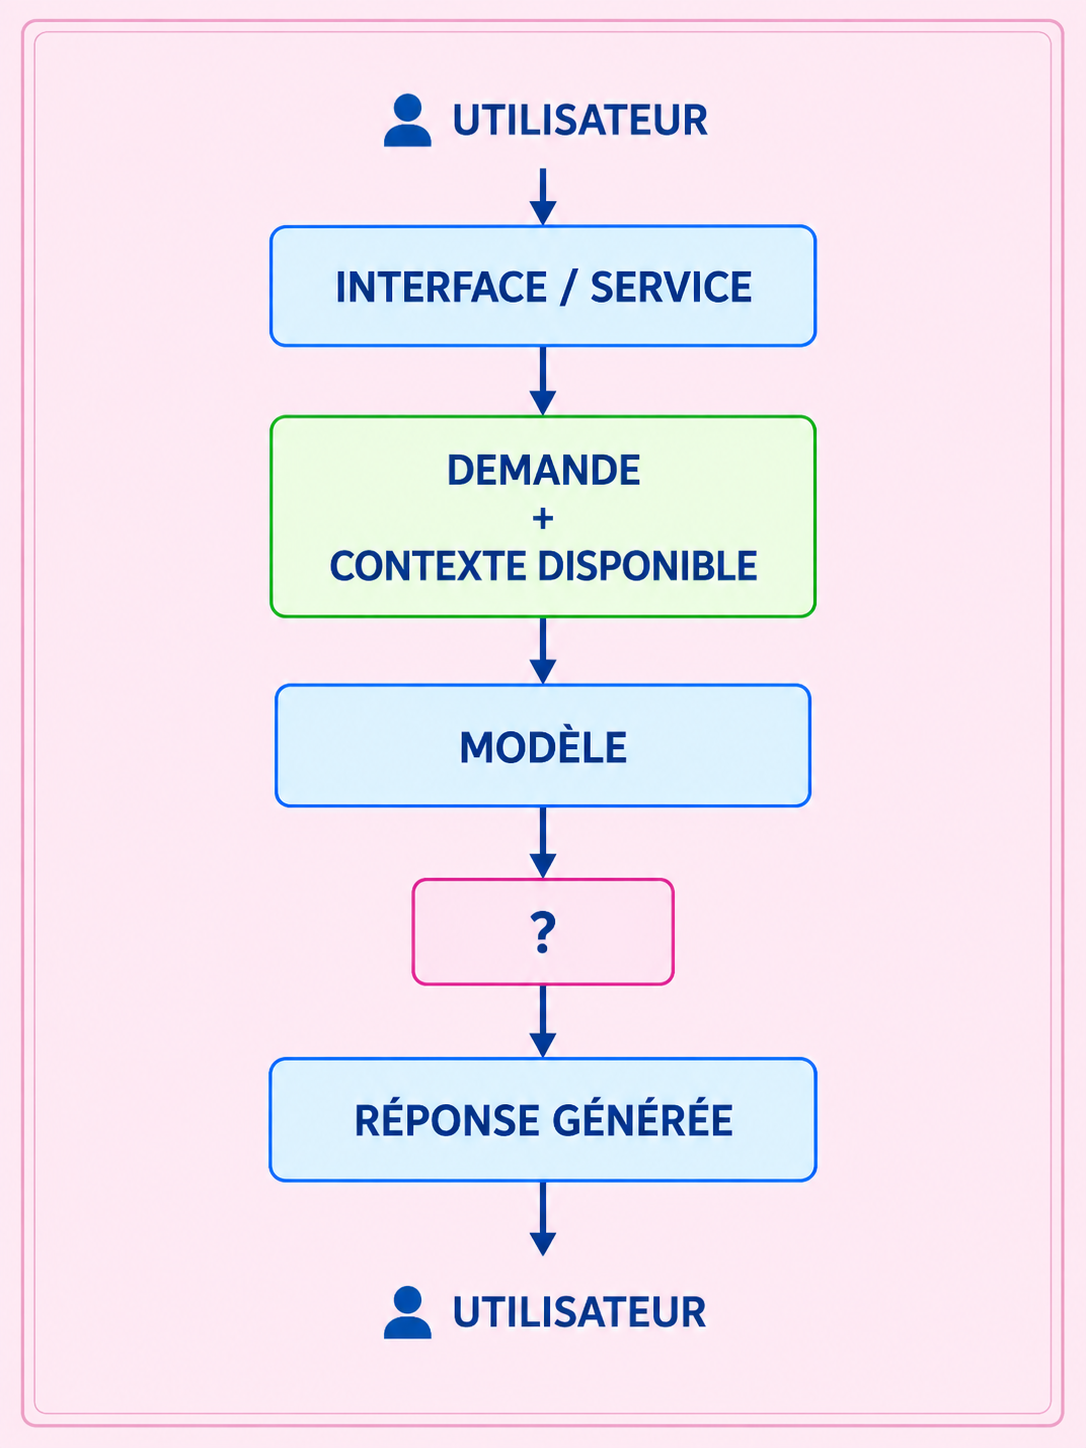
Schéma de la première représentation
Sans consulter de schéma corrigé, enrichissez cette représentation uniquement avec ce que l’Étape 5 vous permet désormais de justifier.
Pour chaque élément ajouté ou déplacé, indiquez l’observation ou la source qui vous autorise à le faire.
Conservez un « ? » partout où l’Étape 5 ne vous permet pas de conclure. Quelles incertitudes restent ouvertes ?
CONFRONTEZ VOTRE SCHÉMA
🔎
Comparez votre modèle enrichi avec celui d’un autre groupe. Identifiez au moins un désaccord.
Défendez votre représentation à partir de vos observations et de vos sources.
Révisez votre modèle uniquement si un argument, une observation ou une source le justifie. Qu’avez-vous modifié, ou pourquoi n’avez-vous rien modifié ?
SCHÉMA DE MISE EN COMMUN — À CONSULTER APRÈS VOTRE CONFRONTATION
Schéma enrichi
CE QUE NOUS POUVONS ÉTABLIR À CE STADE
✅

À partir des observations et vérifications réalisées dans cette étape, nous pouvons maintenant établir que :

Le texte soumis à un modèle de langage est tokenisé avant son traitement par le modèle.

Un token ne correspond pas nécessairement à un mot.

La manière dont un texte est tokenisé dépend du tokenizer utilisé.

Un même texte peut donc produire des tokenisations différentes selon le tokenizer considéré.

Les tokens sont associés à des identifiants puis à des représentations numériques utilisées par le modèle.

La quantité d’informations pouvant être prise en compte dans un contexte donné est limitée et dépend notamment du modèle et du système considérés.

Pour chacune de ces affirmations, indiquez ce qui la soutient : une observation expérimentale, une documentation, ou les deux. Si une formulation vous paraît aller au-delà de ce que vous avez réellement établi, contestez-la.

Et surtout :

Comprendre la demande humaine ne suffit pas : il faut aussi comprendre comment cette demande est représentée pour être traitée par le modèle.
À CONSERVER DANS VOTRE CARNET
📓

Conservez :

  • votre hypothèse initiale sur le traitement du texte ;
  • vos découpages manuels et les critères utilisés pour les construire ;
  • le découpage observé avec le premier tokenizer ;
  • votre série d’essais et vos prédictions ;
  • les résultats qui ont confirmé, fragilisé ou modifié votre représentation ;
  • la comparaison entre les différents tokenizers ;
  • les sources permettant d’associer un tokenizer à un modèle ou à une famille de modèles ;
  • le niveau de certitude associé à ces informations ;
  • les associations qui restent incertaines ;
  • la relation token → identifiant → représentation numérique ;
  • votre recherche sur la fenêtre de contexte, avec le modèle étudié, la source et la date de consultation ;
  • votre schéma de l’étape 4 enrichi et les justifications de vos modifications.

Et surtout :

Une idée que vous pensiez vraie au début de l’expérience et que vous avez dû modifier :
Une question que cette expérience vous conduit maintenant à poser :
Une affirmation que vous refusez désormais de formuler comme une règle universelle, et pourquoi :
🔖 À RETENIR

Le modèle ne reçoit pas simplement « vos mots » tels que vous les percevez.

TOKEN ≠ MOT

La manière dont le texte est tokenisé dépend du tokenizer utilisé.

Un même texte n’est donc pas nécessairement découpé de la même manière pour tous les modèles.

Un outil tiers peut permettre d’explorer une tokenisation sans suffire, à lui seul, à établir celle réellement utilisée par un modèle ou un service donné.

Le contexte pouvant être pris en compte est limité.

Transformer le texte permet au modèle de le traiter ; cela n’explique pas encore comment il produit une réponse.